 |
利用Chromium 平台的微流控芯片对微量(1ng)基因组 DNA 进行精确分区,将DNA 片段分配到大量的携带特异性 barcode 序列的微滴中,每一个微滴都是一个独立的反应体系,在微滴中通过 PCR 扩增制备
10× Genomics 文库,对制备好的文库在 Illumina 测序平台上测序。通过将来自同一长片段模板具有相同 barcode 的reads 进行连 接,输出超长 linked-reads,获得 DNA 长片段的遗传信息。
|
|||||||||||||||||
| [发表评论] [本类其他服务] [本类其他服务商] | ||||||||||||||||||
| 服务商: 北京诺禾致源科技股份有限公司 | 查看该公司所有服务 >> |
Linked-reads技术简介
10× Genomics 公司的linked-reads 技术本质上是利用Chromium 平台的微流控芯片对微量(1ng)基因组 DNA 进行精确分区,将DNA 片段分配到大量的携带特异性 barcode 序列的微滴中,每一个微滴都是一个独立的反应体系,在微滴中通过 PCR 扩增制备10× Genomics 文库,对制备好的文库在 Illumina 测序平台上测序。通过将来自同一长片段模板具有相同 barcode 的reads 进行连接,输出超长 linked-reads,获得 DNA 长片段的遗传信息。
De novo assembly工作流程
10× Genomics de novo assembly 工作流程包括高分子量DNA 制备、Chromium 平台进行文库构建、Illumina 平台测序以及组装软件进行组装等过程。
1、DNA 样品制备:总量不低于2μg;主带大于50Kb,大于100Kb更好。
2、文库构建:含有 barcode 信息的凝胶珠通过“双十字”微流体,在第一个连接处结合 DNA 以及酶的混合物,第二个连接处包裹上油滴形成 GEMs 并进行收集。凝胶珠溶解释放含有 barcode 的序列,随机引物结合在油滴反应体系内长链 DNA 模板的随机位置上进行PCR 扩增,将每个油滴中扩增后获得的含有 barcode 信息的DNA 片段混合。在片段的另一端连接 Illumina Read 2, 最后通过样品Index PCR 引入Illumina 测序P5/P7 接头和样品index,完成文库构建。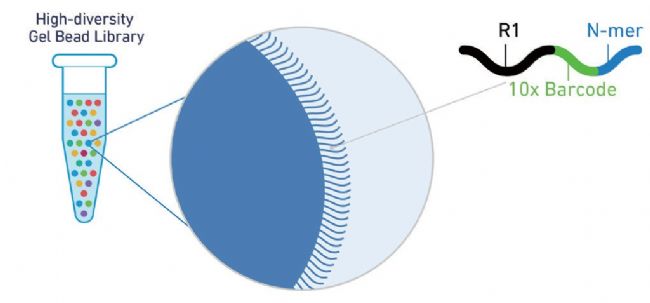
图1 10× Genomics凝胶珠的特征
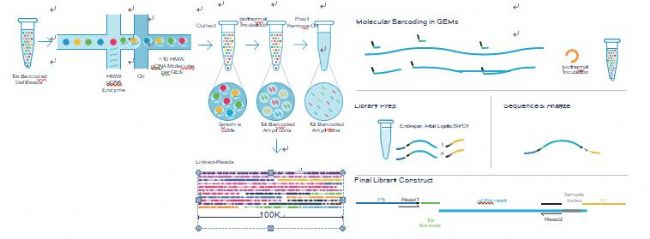
图2 10× Genomics linked-reads文库构建
技术优势
10× Genomics de novo assembly 仅需构建一个 10× Genomics 文库,利用Supernova™ Assembler 软件即可进行组装,操作过程简单,组装成本低、质量高。
1、DNA需求量低:仅需1ng基因组 DNA 即可得到长片段DNA 文库(原始DNA 量需>2ug)。
2、长跨度信息:根据 barcode 信息将多个Reads 进行拼接,可获得长达100Kb的跨度信息。
3、组装周期短:从样本 DNA 提取到组装完成仅需2~3周。
4、二倍体组装:10× Genomics可实现真正的二倍体组装,揭示样本特异性序列,发现真实的基因组信息,研究二倍体基因组结构。
Supernova组装案例(植物)
应用方向
单个参考基因组的构建
在一个物种已有参考基因组的情况下,对具有重要性状的栽培种、野Th种开展10× Genomics de novo 测序,可以快速获得物种高质量基因组,挖掘品种特有基因,鉴定重要基因结构变异。
1、辣椒基因组(Horticulture Research,2018)
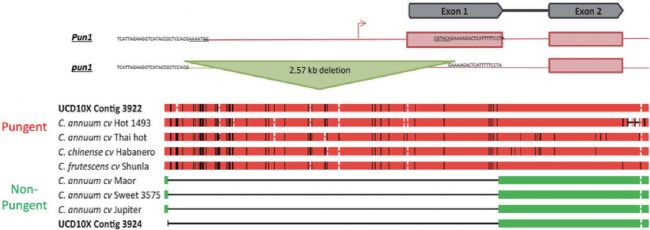
辣椒基因组是一个代表性的复杂植物基因组,基因组大小达3.5Gb,其中75%~80%为重复序列。研究利用10× Genomics linked-reads 技术对一个辣椒杂合 F1 个体进行测序和组装,最终获得的基因组大小为3.21Gb,scaffold N50=3.69Mb,组装得到的序列在准确性和连续性上优于目前所有的辣椒参考基因组。通过 phased 组装方法,F1 中脂肪酰转移酶 PUN1 基因中 2.5Kb 的插入/缺失单倍型(代表辣和不辣两种类型)均被完整地组装出来。高质量的辣椒基因组组装表明 linked-reads 技术为低成本组装复杂植物基因组以及通过精确的单倍型构建比较基因结构变异提供了一个途径。
10× Genomics 公司的linked-reads 技术本质上是利用Chromium 平台的微流控芯片对微量(1ng)基因组 DNA 进行精确分区,将DNA 片段分配到大量的携带特异性 barcode 序列的微滴中,每一个微滴都是一个独立的反应体系,在微滴中通过 PCR 扩增制备10× Genomics 文库,对制备好的文库在 Illumina 测序平台上测序。通过将来自同一长片段模板具有相同 barcode 的reads 进行连接,输出超长 linked-reads,获得 DNA 长片段的遗传信息。
De novo assembly工作流程
10× Genomics de novo assembly 工作流程包括高分子量DNA 制备、Chromium 平台进行文库构建、Illumina 平台测序以及组装软件进行组装等过程。
1、DNA 样品制备:总量不低于2μg;主带大于50Kb,大于100Kb更好。
2、文库构建:含有 barcode 信息的凝胶珠通过“双十字”微流体,在第一个连接处结合 DNA 以及酶的混合物,第二个连接处包裹上油滴形成 GEMs 并进行收集。凝胶珠溶解释放含有 barcode 的序列,随机引物结合在油滴反应体系内长链 DNA 模板的随机位置上进行PCR 扩增,将每个油滴中扩增后获得的含有 barcode 信息的DNA 片段混合。在片段的另一端连接 Illumina Read 2, 最后通过样品Index PCR 引入Illumina 测序P5/P7 接头和样品index,完成文库构建。
图1 10× Genomics凝胶珠的特征
图2 10× Genomics linked-reads文库构建
3、上机测序:在 Illumina/Hiseq X 平台上进行双末端150bp 测序。
4、De novo 组装:利用10× Genomics 的Supernova™ Assembler 组装,输出结果。技术优势
10× Genomics de novo assembly 仅需构建一个 10× Genomics 文库,利用Supernova™ Assembler 软件即可进行组装,操作过程简单,组装成本低、质量高。
1、DNA需求量低:仅需1ng基因组 DNA 即可得到长片段DNA 文库(原始DNA 量需>2ug)。
2、长跨度信息:根据 barcode 信息将多个Reads 进行拼接,可获得长达100Kb的跨度信息。
3、组装周期短:从样本 DNA 提取到组装完成仅需2~3周。
4、二倍体组装:10× Genomics可实现真正的二倍体组装,揭示样本特异性序列,发现真实的基因组信息,研究二倍体基因组结构。
Supernova组装案例(植物)
| 物种名称 | 发表期刊 | 发表单位 | 技术策略 | 组装软件 | 组装结果 |
| 玉米B73 Maize B73 |
BMC Genomics 2018.9 |
爱荷华州立大学 |
10×Chromium linked-reads read depth:45× |
supernova Assembler version 1.1.0 |
Contigs Number:234,153 Contig N50=14.5Kb Scaffolds Number: 172,000 Scaffold N50=89Kb Total Size: 1.28Gb Genome Coverage:50% |
| 糜子Panicum miliaceum |
BMC Genomics 2018.9 |
爱荷华州立大学 |
10×Chromium linked-reads read depth:107× |
Supernova Assembler version 1.1.5 |
Scaffolds Number:30,819 Scaffold N50=912Kb Total Size: 823Mb Genome Coverage:83% |
| Contigs Number:134,573 | |||||
| 辣椒Capsicum annuum | Horticulture Research 2018.1 | 加州大学 | 10×Chromium linked-reads read depth:56× | Supernova Assembler version 1.1 | Contig N50= 123Kb Scaffolds Number:83,391 Scaffold N50= 3.69Mb Total Size: 3.21Gb |
| Genome Coverage: 92% | |||||
| Contigs Number:66825 | |||||
| 野Th大豆Glycine latifolia | The Plant Journal 2018.4 | 伊利诺伊大学 | 10×Chromium linked-reads read depth:56× | Supernova Assembler version 1.1.5 | Contig N50=62.61kb Scaffolds Number:42,539 Scaffold N50=853.6 kb Total Size: 939.7Mb Genome Coverage:83.2% |
应用方向
单个参考基因组的构建
在一个物种已有参考基因组的情况下,对具有重要性状的栽培种、野Th种开展10× Genomics de novo 测序,可以快速获得物种高质量基因组,挖掘品种特有基因,鉴定重要基因结构变异。
1、辣椒基因组(Horticulture Research,2018)
辣椒基因组是一个代表性的复杂植物基因组,基因组大小达3.5Gb,其中75%~80%为重复序列。研究利用10× Genomics linked-reads 技术对一个辣椒杂合 F1 个体进行测序和组装,最终获得的基因组大小为3.21Gb,scaffold N50=3.69Mb,组装得到的序列在准确性和连续性上优于目前所有的辣椒参考基因组。通过 phased 组装方法,F1 中脂肪酰转移酶 PUN1 基因中 2.5Kb 的插入/缺失单倍型(代表辣和不辣两种类型)均被完整地组装出来。高质量的辣椒基因组组装表明 linked-reads 技术为低成本组装复杂植物基因组以及通过精确的单倍型构建比较基因结构变异提供了一个途径。
图3 F1中PUN1 基因2.5Kb的PAV 被完全重建
2、大豆野Th近缘种基因组(Plant Journal,2018)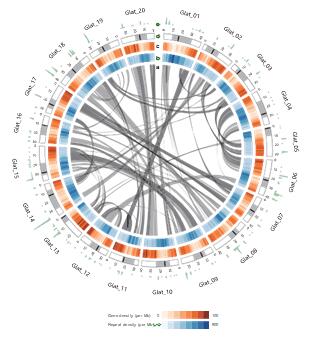
泛基因组研究
与常规的二代测序组装方案相比,10× Genomics de novo 只需较少的 DNA 量和较短的组装周期就可以获得较好的组装结果,非常适合于泛基因组研究。
17个人泛基因(Nature Communications,2018)
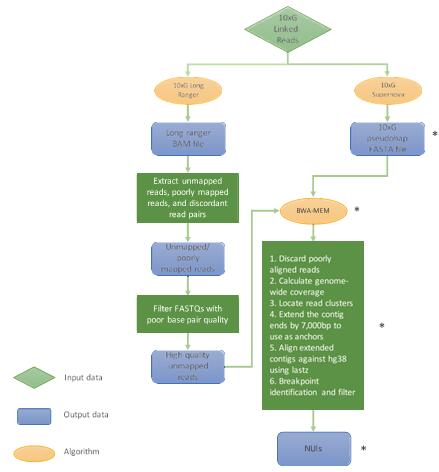
人类参考基因组被广泛应用于现代Th物学研究,然而一个参考基因组并不能代表人类群体的完整遗传信息。研究利用 10× Genomics ed-reads 技术,对来自5个不同人群的17个人(5个非洲人、3个北美人、4个东亚人、3个欧洲人和2个南亚人)进行全基因组测序和 de novo组装。在17个基因组中鉴定了1842个不存在于参考基因组且唯一的插入变异(non-reference unique insertions,NUIs),总长达2.1Mb。其中64%的NUI 在非人类的灵长类基因组中也有发现,是人类祖先序列;37%的NUI 在人类转录组中发现;14% 可能来自于Alu重复序列重组介导的删除。研究强调需要一系列包含不同人种的参考基因组来绘制人群完整的遗传多样性变异图谱。
技术策略与组装指标
参考文献
Glycine latifolia 是大豆的27 个野Th多年Th 近缘种之一,具有许多大豆不具备的遗传多样性和优异农艺性状。研究利用10× Genomics linked-reads 技术组装了939Mb的G. latifolia 基因组草图。利用遗传图谱和大豆基因组序列信息,将 Scaffolds 挂载到了20个染色体级别的假分子中。在组装基因组中鉴定到了304个NBS-LRR 类抗病蛋白基因和367个参与基础防御响应和非Th物胁迫响应的 LRR 类受体激酶基因。G. latifolia 基因组的组装和注释为促进大豆的遗传改良提供了宝贵资源。
右图4 Glycine latifolia 基因组结构
泛基因组研究
与常规的二代测序组装方案相比,10× Genomics de novo 只需较少的 DNA 量和较短的组装周期就可以获得较好的组装结果,非常适合于泛基因组研究。
17个人泛基因(Nature Communications,2018)
人类参考基因组被广泛应用于现代Th物学研究,然而一个参考基因组并不能代表人类群体的完整遗传信息。研究利用 10× Genomics ed-reads 技术,对来自5个不同人群的17个人(5个非洲人、3个北美人、4个东亚人、3个欧洲人和2个南亚人)进行全基因组测序和 de novo组装。在17个基因组中鉴定了1842个不存在于参考基因组且唯一的插入变异(non-reference unique insertions,NUIs),总长达2.1Mb。其中64%的NUI 在非人类的灵长类基因组中也有发现,是人类祖先序列;37%的NUI 在人类转录组中发现;14% 可能来自于Alu重复序列重组介导的删除。研究强调需要一系列包含不同人种的参考基因组来绘制人群完整的遗传多样性变异图谱。
图5 NUI鉴定的策略和流程
技术策略与组装指标
| 10× Genomics de novo assembly | |
| 基因组DNA | 总量不低于2μg;主带大于50Kb,大于100Kb更好 |
| 文库类型 | 一个10× Genomics文库 |
| 测序数据量 | 120G或180G |
| 组装指标 | ContigN50>30Kb;ScaffoldN50>1Mb |
参考文献
- Weisenfeld N I, Kumar V, Shah P, et al. Direct determination of diploid genome sequences[J]. Genome Research, 2017, 27(5):757-767.
- Hulse-Kemp A M , Maheshwari S , Stoffel K , et al. Reference quality assembly of the 3.5-Gb genome of Capsicum annuum from a single linked-read library[J]. Horticulture Research, 2018, 5(1):4.
- Liu Q , Chang S , Hartman G L , et al. Assembly and annotation of a draft genome sequence for Glycine latifolia, a perennial wild relative of soybean[J]. Plant Journal, 2018.
- Wong K H Y , Levysakin M , Kwok P Y . De novo human genome assemblies reveal spectrum of alternative haplotypes in diverse populations[J]. Nature Communications, 2018, 9(1).




Copyright(C) 1998-2026 生物器材网 电话:021-64166852;13621656896 E-mail:info@bio-equip.com