AGENTEX:自动化遗传密码原型设计平台的开发与应用
关键词:遗传密码;无细胞翻译;tRNA氨酰化
- 研究背景
人工合成遗传密码能够赋予生命体抗病毒、抑制基因水平转移等全新性状,也支持基因编码功能材料、药物与生物催化剂的制备。通过改造核糖体、tRNA以及氨酰-tRNA合成酶(aaRS),目前已经可以在活细胞中将四百余种非标准氨基酸导入蛋白质,合成序列精准可控的生物聚合物。但该领域仍存在技术瓶颈,很难在全基因组范围内完成多个有义密码子的重分配,也难以实现多种非标准氨基酸的高纯度多肽掺入。要实现从基因序列到化学产物的完全控制,还需对翻译系统进行深度改造。受限于基因组合成与编辑的巨大难度,直接在活体内调试全新遗传密码成本高、风险大;两类主流无细胞翻译体系又各有短板,裂解物体系更贴近生理环境、可放大生产生产,却会受内源tRNA的交叉干扰,而无内源tRNA干扰的PURE重构系统又不适合规模化制备。
针对上述困境,2026年8月哈佛医学院Felix Radford和George M. Church团队在《Nature》发表题为“Automated prototyping of genetic codes”的研究论文。该研究发现tRNA的3’端具备很强的突变耐受能力,大肠杆菌全部氨酰-tRNA合成酶均可对绝大多数otRNA(非CCA-3’端tRNA)完成氨酰化修饰,更新了学界对tRNA保守CCA末端以及遗传密码维持机制的认知。基于该发现,研究团队开发出AGENTEX平台,可以在无细胞翻译系统中,高通量完成各类全新人工遗传密码的原型构建与测试。
在研究中,LC-MS/MS作为直接表征翻译产物的金标准手段,弥补了荧光报告基因仅能间接反映翻译活性的局限。其中,DIA蛋白质组学质谱数据采用PEAKS® Studio软件完成分析,用于评估AGENTEX平台的翻译交叉干扰。
- 核心技术开发
整套翻译反应在粗提细胞裂解液中开展,保留完整的翻译机制同时含有RNA加工、翻译后修饰的相关酶系。研究人员改造tRNA保守的3'‑CCA末端,得到otRNA;同时对大肠杆菌23S rRNA引入G2251C、G2553C双点突变,得到工程化CGA核糖体。在裂解液中导入突变核糖体,并仅外源添加otRNA,由此构建连贯、高通量的AGENTEX工作流程。
该体系依靠改造后的核糖体实现翻译层面的正交隔离,内源aaRS仍可正常对otRNA进行氨酰化修饰,从而实现天然内源翻译通路与人工正交翻译通路共存。该平台支持多路并行自动化完成遗传密码构建与性能测试,解决了传统方案翻译交叉串扰的难题,省去大量繁琐手工操作。
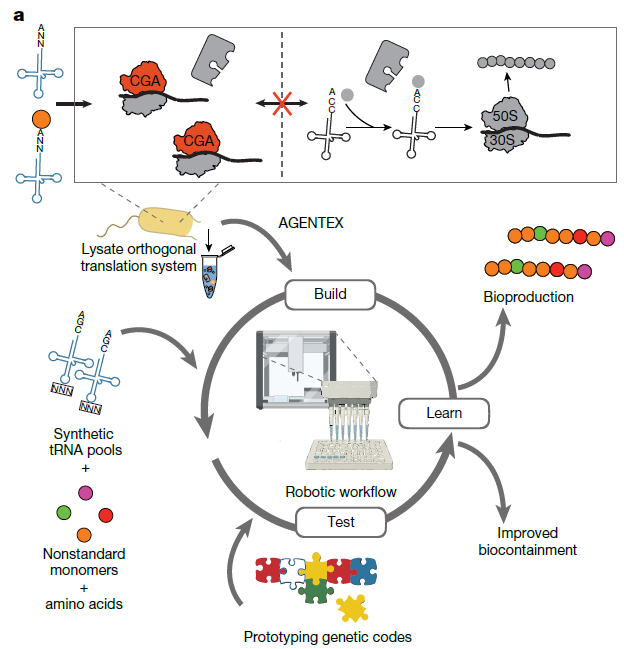
图 1|AGENTEX实现遗传密码的多路并行测试
- 研究结果
氨酰化就是把氨基酸共价连接到tRNA的3’末端上的反应,由aaRS催化。只有成功氨酰化的tRNA才能进入核糖体参与多肽链的合成,因此氨酰化效率是评价otRNA是否可用的首要指标。
tRNA存在丰富的共价修饰,影响aaRS对tRNA的识别效果,而且带有非CCA这类非天然末端的tRNA很难在活细胞内部正常成熟加工。传统的tRNA氨酰化检测方案要么依赖活细胞体系,不适合非天然tRNA;要么只能逐个检测tRNA,难以实现高通量分析的需求。
因此,作者开发tSCAN高通量检测技术,采用大肠杆菌裂解物无细胞体系,使用体外合成的tRNA文库,依靠裂解物内源aaRS完成氨酰化反应。该方法结合高碘酸盐化学处理与新一代测序:氨酰化的tRNA3’端被氨基酸保护,不会被高碘酸氧化;未装载氨基酸的空载tRNA则会被氧化,丢失末端腺苷。通过统计每种tRNA的完整测序读段与截短测序读段的比值,即可对氨酰化水平进行定量。整套流程依托Opentrons OT‑2机器人与磁珠纯化实现自动化多路并行(图2 a, b)。
利用两种古菌的全套外源tRNA文库开展验证,将tRNA置于大肠杆菌裂解物孵育后,使用tSCAN检测。结果复现已知正交tRNAPyl低氨酰化的文献结果,同时筛选出若干潜在新型正交tRNA,证明tSCAN可通过测定氨酰化效率,可靠评估tRNA与宿主翻译系统之间的交叉反应(图 2c,d)。
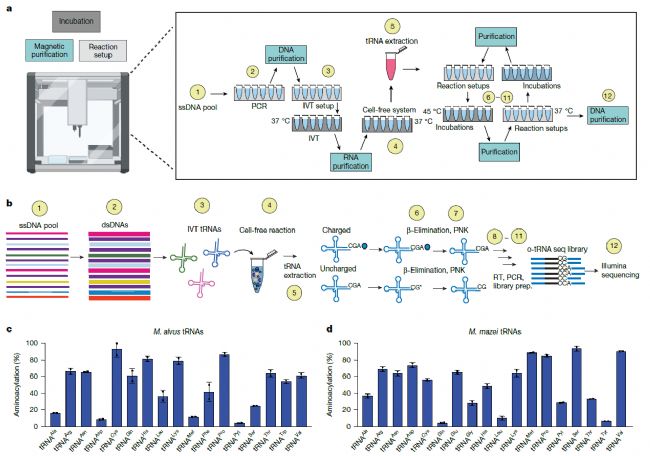
图 2|借助tSCAN实现氨酰化水平自动化检测
2. 大肠杆菌所有aaRS均可对非-CCA末端tRNA完成氨酰化,提示tRNA 3’末端存在序列可变性过去传统观点认为,3’-CCA末端是绝大多数tRNA发生氨酰化必不可少的结构。利用已经建立的tSCAN高通量手段,研究对大量3’末端序列发生改变的大肠杆菌tRNA文库开展测定。构建了3’末端分别为天然CCA,以及突变后的CGA、CUA、CAA的tRNA文库,用来评估不同3’端序列对氨酰化的影响。
为区分tRNA碱基修饰带来的作用,设置两套无细胞体系相互对照:
第一套是PURExpress重构型无细胞翻译体系(图 3a, b),该体系组分全部为纯化重组蛋白,不含tRNA修饰相关酶,tRNA不会发生碱基修饰,以此反映无修饰状态下各类tRNA的氨酰化情况。
第二套为大肠杆菌裂解物无细胞体系(图 3c, d),裂解物保留大肠杆菌全部内源酶系,包含tRNA碱基修饰酶,tRNA会产生天然共价修饰,可以模拟体内带有修饰的真实状态。
实验结果显示,在含有tRNA修饰酶的裂解物体系中,几乎所有大肠杆菌aaRS都可以对非-CCA末端的otRNA完成氨酰化,挑战了过去的固有认知;但在无修饰的PURE体系中,多数otRNA的氨酰化效率显著下降。研究继续对比了tRNA碱基修饰对氨酰化的影响,发现tRNA的修饰状态会改变otRNA的氨酰化效率,当tRNA的3’末端序列发生改变时,修饰带来的影响会表现得更加明显。
这就说明,otRNA真正的限制因素并不是aaRS无法给它装载氨基酸;即便多数otRNA能够顺利完成氨酰化,野生型核糖体依旧难以识别接纳这类otRNA,这才是阻碍otRNA参与翻译过程的关键瓶颈。该结果也解释了CCA在自然界中普遍保守的原因,CCA的保守更多是服务于核糖体识别,而不是主要服务于aaRS的氨酰化反应。
这部分实验结果为后续AGENTEX平台构建人工压缩遗传密码提供核心依据:既然otRNA可以被内源aaRS完成氨酰化,就可以在裂解物体系中搭配突变核糖体,实现人工遗传密码的测试。
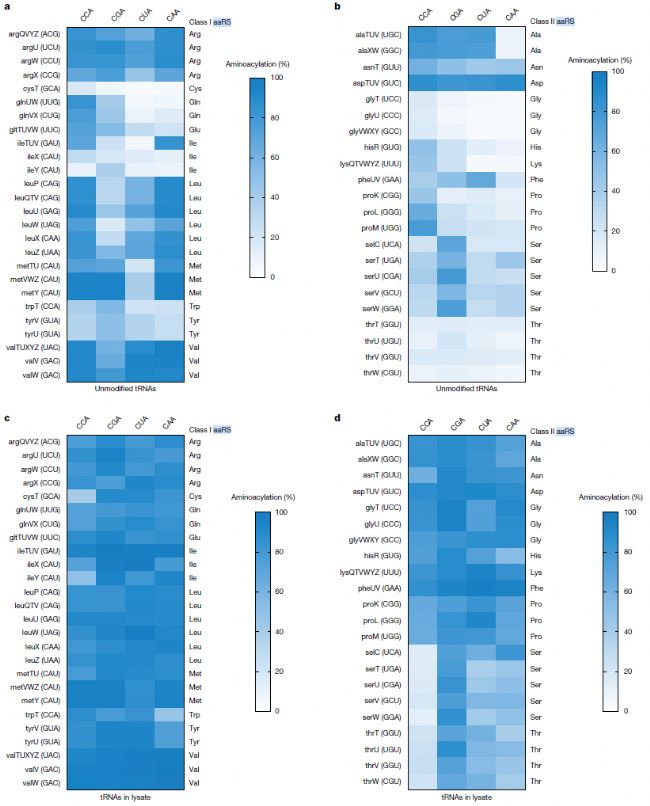
图 3|分析3’末端为CCA、CGA、CUA、CAA,且有无RNA修饰条件下的tRNA氨酰化水平
3. 探究tRNA 3’末端倒数两位碱基的序列可变性在前文发现大肠杆菌aaRS可耐受tRNA 3’末端75位碱基替换的基础上,进一步探究74、75位碱基发生简并突变后,能否依旧被aaRS用作氨酰化底物。
实验结果显示,tRNA的74、75位碱基具备较广的序列容忍度,多种碱基组合依旧可以支持aaRS完成氨酰化;但序列为GCA时会造成约60%的tRNA氨酰化效率显著下降;相同的碱基突变,不同同工tRNA的耐受程度差异明显,如同为丙氨酸-tRNA,alaTUV对突变耐受性更强,alaXW则更容易出现氨酰化受损(图4)。结合前人已发表研究以及后续核糖体翻译实验结果:GCA末端tRNA氨酰化普遍受损,但核糖体仍可微弱识别;CGA末端可实现氨酰化,却几乎不能被野生核糖体接纳,证明氨酰化装载、核糖体识别属于两套相互独立的筛选过程。该部分结果完善了受体茎序列调控氨酰化的认知,为筛选可用otRNA构建人工遗传密码提供数据支撑。
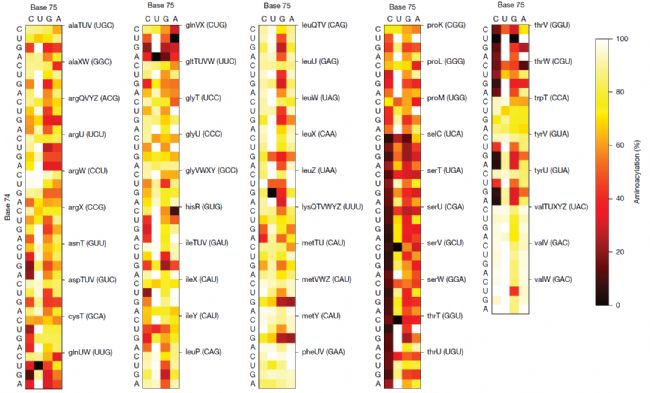
图 4|3’-CCA末端完全变异的大肠杆菌tRNA可被天然大肠杆菌氨酰-tRNA合成酶催化氨酰化
4. 核糖体是维持标准遗传密码的决定性屏障既然氨酰化步骤可以发生在非-CCA-tRNA,就引出一个关键问题:生理环境中,为什么这类非天然末端tRNA几乎不参与细胞内的翻译过程。
接下来研究人员继续探究工程化otRNA是否能够在野生型核糖体(23S rRNA无G2251C、G2553C突变)的天然翻译系统中参与翻译。作者提出假设:野生核糖体能够通过和tRNA受体茎相互作用,优先选择3’-CCA末端的tRNA,即便otRNA已经被大肠杆菌aaRS完成氨酰化,也会被核糖体排斥(图5 a)。
为检验是否会发生翻译交叉干扰,研究者基于前期tSCAN的数据,体外转录构建了CGA-otRNA文库(MP1),这套文库覆盖全部20种氨基酸以及甲硫氨酸起始tRNA的最小编码集合(图5 b);随后将MP1文库加入无细胞翻译体系,体系内同时含有大肠杆菌内源氨酰化tRNA以及aaRS。文库中将丙氨酸tRNA和丝氨酸tRNA的反密码子进行互换,实验设计了ELP-AAA、ELP-SSS两种多肽报告底物,依靠LC-MS/MS质谱检测多肽产物,判断报告多肽的丙氨酸和丝氨酸密码子位置,是CGA-tRNA参与解码,还是内源tRNA发挥解码作用。
实验设置添加MP1文库和不添加MP1文库的对照组别,分别使用不同的报告DNA模板开展翻译,结果显示:
无论体系中添加MP1文库(图 5c, d)还是不添加MP1文库(图 5e, f),均可以检出ELP-AAA信号;两组实验均未发现otRNA造成氨基酸错掺入的证据。与之类似,无论添加MP1文库(图 5g, h)还是不添加MP1文库(图 5i, j),均可通过LC-MS/MS检测并确认ELP-SSS报告多肽;两组同样均未观察到otRNA引发错配掺入的现象。
总之,没有检测到CGA末端otRNA被野生核糖体接纳并参与翻译的证据。虽然otRNA可以被大肠杆菌内源aaRS氨酰化,但野生核糖体起到过滤屏障的作用,阻止otRNA进入翻译过程。
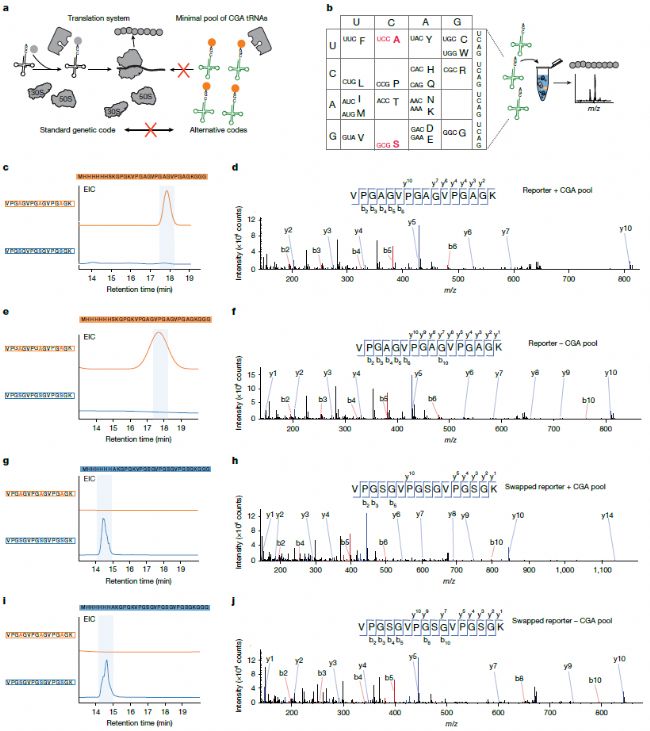
图 5|核糖体与tRNA的3’末端共同阻止不同遗传密码之间发生交叉干扰
5. AGENTEX实现压缩遗传密码与非标准氨基酸翻译在证实野生型核糖体可以作为筛选屏障,阻止CGA-otRNA参与翻译之后,研究人员进一步利用AGENTEX平台构建压缩遗传密码。该平台的核心是引入经过工程改造的CGA突变核糖体(23S rRNA发生G2251C/G2553C突变),突变后的核糖体可以特异性识别3’-CGA末端的otRNA。
实验合成了一套精简的tRNA文库(MP2),文库内otRNA的3’末端均为CGA,包含1条甲硫氨酸起始otRNA以及分别对应全部20种标准氨基酸的20条otRNA。文库中丝氨酸与丙氨酸的tRNA反密码子进行互换,每种标准氨基酸仅由单一otRNA解码(图6 a);文库还引入詹氏甲烷球菌(Methanocaldococcus jannaschii)来源的tRNATyrCUA,用于识别UAG密码子;体系中共加入pazFRS,可将非天然氨基酸对-叠氮-L-苯丙氨酸(pazF)装载到该otRNA上。
研究搭建了基于HiBiT‑LgBiT的高灵敏度发光报告体系h‑TAG‑1,用来快速评估重编码遗传密码的翻译效果(图6 b)。h‑TAG‑1报告肽在HiBiT序列上游设置了含有UAG终止密码子的短肽序列。如果翻译能够顺利完成,就会生成完整的HiBiT多肽,和LgBiT结合之后恢复荧光素酶活性,产生发光信号;如果MP2文库的otRNA无法被核糖体接纳,没有otRNA识别UAG,翻译会在UAG位点提前终止,同时HiBiT片段还会出现氨基酸错配。
实验分别在含有野生核糖体和CGA突变核糖体的裂解液中开展翻译,设置是否添加pazF、pazFRS以及报告基因模板的对照。结果显示,在CGA突变核糖体体系中,同时加入MP2文库以及pazF、pazFRS的条件下,HiBiT的产量显著提升,远高于野生核糖体组别和无模板对照组;而当体系缺少有功能的pazFRS时,无论哪种核糖体,发光信号都处于本底水平(图 6c),说明观测到的强发光信号确实来自正确的解码过程。
为进一步确认otRNA能否被CGA突变核糖体接纳,同时排查是否存在和天然核糖体之间的翻译交叉干扰,研究者使用高灵敏度质谱仪做LC‑MS/MS多肽鉴定。实验改用MP1 tRNA文库构建21密码子体系,翻译ELP‑SAS多肽(图6 d-h),这个多肽有3个关键密码位点,解码产物会随着所用遗传密码不同而改变,适合用来判断是否发生氨基酸错掺;同时该多肽长度为32个氨基酸,也可以用来检验otRNA连续解码生成长肽的能力。研究对目标肽段的提取离子流图以及二级质谱谱图开展解析。
携带CGA核糖体的裂解液样本内同时存在野生核糖体与突变核糖体,质谱结果既检出内源翻译的标准密码子产物(图6 f),也检出otRNA介导的压缩密码子翻译产物(图6 e),没有发现代表交叉干扰的丙氨酸‑丝氨酸错误替换,部分质量匹配的峰经二级谱确认属于假阳性;而野生核糖体裂解液中仅检测到内源翻译产物(图6 g, h),不存在otRNA驱动的翻译产物。
质谱结果和h‑TAG‑1发光实验结果可以互相印证。整套实验证明AGENTEX平台能够实现携带非天然单体的多肽以及两套压缩遗传密码的多肽翻译。当核糖体肽基转移酶中心存在G2251C、G2553C突变形成CGA核糖体后,otRNA能够被天然aaRS完成氨酰化,之后被突变核糖体选择性且高效地接纳参与多肽合成。
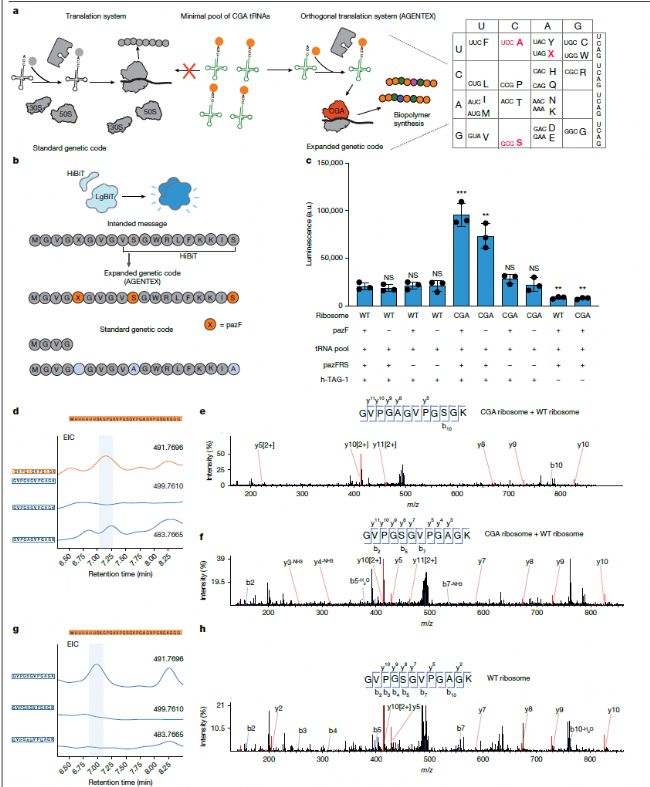
图 6|利用 otRNA 顺序解码与突变核糖体实现扩展遗传密码的多肽翻译
- 总结
文献信息:
标题:Automated prototyping of genetic codes
期刊:Nature
DOI:10.1038/s41586-026-10949-y
PEAKS® Studio和PEAKS® Online兼容各种仪器类型产生的DIA数据,并将谱图库(Spectral library)搜索、直接数据库搜索(database search),以及DIA突变(Sequence Variants)、DIA未知修饰和DIA de novo分析开创性地整合为一站式分析流程,全方位满足DIA数据分析需求。PEAKS®13.5对DIA分析进行了全面升级,在分析速度与深度、定量准确度方面均有显著提升。同时,可实现DIA未知修饰及序列变异挖掘,并辅助发现数据库中不包含的新肽段。如有数据分析需求,可通过文末的联系方式找到我们,预约一对一技术介绍。