Evosep One研究进展:SPIN-通过蛋白质组学研究物种
期刊:bioRxiv - Biochemistry
发表日期:2021- 02-23
研究机构:丹麦哥本哈根大学诺和诺德基金会蛋白质研究中心
研究背景:
基因物种鉴定已成为法医学、考古学、生态学和食品认证中不可或缺的工具。现有的方法要么适用于检测多个样本中的单个分类单元,要么适用于在几个样本中筛选广泛的物种。在这里,我们介绍“蛋白质组研究物种”(SPIN),这是一种蛋白质组学工作流程,能够在7.2分钟的质谱(MS)分析中查询150多种哺乳动物物种。通过蛋白质聚集捕获、高速色谱和数据独立采集,以及可靠的物种推断算法,简化和自动化样本制备,每天处理数百个样本。我们展示了已知参考文献的正确分类、斯堪的纳维亚退化铁器时代材料中可重复的物种鉴定,并用尼安德特人晚期占领的南欧遗址的旧石器时代中晚期骨骼测试了我们方法的局限性。虽然这项初步研究的重点是现代和考古哺乳动物骨骼,但SPIN将是开放的,并可与其他生物组织和分类群一起扩展。
研究思路及研究结果:
- 样品制备和数据采集
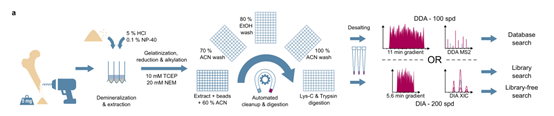
Fig.1样品制备和数据采集
为了提高吞吐量,作者开发了一种新的样品制备方案,该方案由几个手动步骤组成,便于放大(图1)。作者比较了几种不同的提取缓冲液成分,最后选择了盐酸和非离子洗涤剂NP-40的混合物,将脱盐和蛋白质提取结合起来。蛋白质是通过同时脱矿和萃取从骨屑或骨粉中获得的,蛋白质聚集清除磁性小球处理机器人可以自动捕获和消化。肽通过串联质谱快速分离和分析,每天的吞吐量为100个样本(DDA)或每天200个样本(DIA)。
2. 肽快速识别
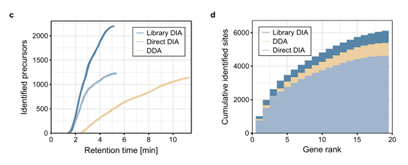
Fig.2比较通过常规数据库搜索分析的快速100 spd DDA方法和通过基于库与无库方法分析的快速200 spd DIA方法在保留时间内累积的前体识别。
SPIN使用非常短的在线LC梯度来加速纳米流色谱与Orbitrap串联质谱联用。与诊断血浆蛋白质组学中最快的采集方法(每天测量约50个样本)或传统蛋白质组学中每天不到10个样本的常用方法相比,我们通过数据独立采集(DIA)和数据依赖采集(DDA)实现了足够的蛋白质组覆盖率,每天可识别多达200个样本和100个样本。在现代牛骨样本中,快速扫描DDA在11分钟内识别出约1200个前体,而当direct DIA在没有光谱库的情况下进行分析时,DIA在5.6分钟内达到相同的识别数量(图2c)。通过对高pH值反相色谱离线分离的多肽进行DDA分析,每个物种需要一次性生成一个专用的光谱库,而DIA分析鉴定出的前体数量几乎是后者的两倍然而,DIA产生了更多的冗余和重叠前体,因此没有产生两倍的绝对序列覆盖(图2d)。在40个现代参考样本中,DDA方法的平均覆盖率为3678个氨基酸,因此优于无库directDIA方法的3226个氨基酸。以文库为基础的DIA的平均覆盖率最高,为4480个氨基酸。
3. 用已知物种的骨骼验证SPIN
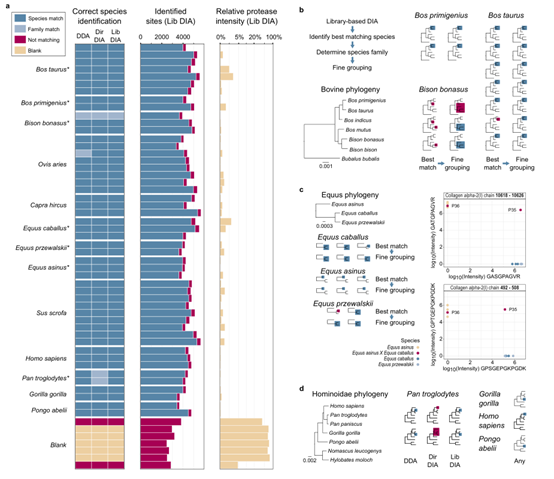
Fig. 3 参考物种分析
作者利用一组来自13个物种的49块已知参考骨对不同数据采集和解释策略的性能进行了优化和评估(图3a)。使用基于库的DIA将所有样本放入正确的属中,而无库的directDIA不能排除黑猩猩是人类,而DDA不能排除8只绵羊样本中的一只是山羊。当涉及到科内分类单元的位置时,这三种方法都表现得同样好。在牛的内部,家养牛(牛牛)可以区别于欧洲野牛(野牛bonasus),但不能区别于原牛(Bos primigenius)。欧洲野牛本身无法与美洲野牛和牦牛区别开来,在一个案例中,还与瘤牛区别开来。在马类中,驯养的马(马科动物caballus)成功地与驴子(马科动物africanus asinus)区分开来,这是PMF无法做到的,但与蒙古野马(马科动物przewalskii)区分不出来。因此,SPIN在技术上能够进行混合检测,但需要对其可靠性进行评估。
4. 性能和再现性基准
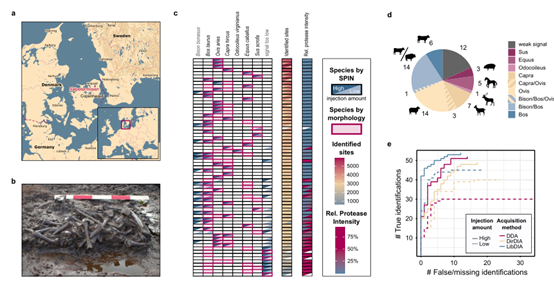
Fig. 4 斯堪的纳维亚铁器时代骨骼的物种鉴定
作者利用文库DIA和精细分组的SPIN分析得到了49个准确的物种鉴定和3个近似的物种鉴定,而11个样品由于肽强度低而被排除(图4B)。副本分析的比较显示,站点覆盖范围为3000个氨基酸的副本之间具有完美的重现性(图4c)。在两个重复的99个样品中,96个样品的文库DIA的SPIN分析与形态学分析一致。作者比较了library DIA、directDIA和DDA三种不同类型肽的鉴定性能,它们对参考样品的鉴定效果非常相似。在Salpetermosen样本集中,差异变得更加明显。伪roc曲线分析表明,基于dia的方法优于DDA,特别是在低重复量的情况下,表明基于dia的测量具有更高的灵敏度(图4d)。在两种DIA方法之间,基于库的DIA比directDIA一致产生更多的真实物种识别。
研究结论:
作者提出了一种新的遗传物种鉴定工作流程,该流程可以弥补高通量靶向方法(如PMF、PCR或ELISA)和更强大的低通量方法(如NGS或传统的LC-MS/MS蛋白质组学分析)之间的差距。我们证明,基于PAC的自动化样品制备工作流可通过LC-MS/MS产生用于骨蛋白质组分析的高质量肽样品,并允许轻松放大。在速度和成本方面,数据采集曾经是一个瓶颈,但现在却大大缩短了,每台MS仪器每天最多可以采集200个样品。用于SPIN的数据解释策略有助于对目前多达156种物种进行无偏比较,并由于FDR在肽和物种识别水平上的控制,提供了较高的可信度。基于对丹麦64块部分降解骨骼的分析,我们得出结论,基于库的DIA方法可以实现最高的置信度和灵敏度。
到目前为止,SPIN数据分析仅限于156个改进文库- dia分析的13个光谱文库。我们设想,随着更多的研究小组共享他们的蛋白质序列数据库和光谱库,这些数字将会增长。此外,随着时间的推移,SPIN工作流本身很可能会得到改进和扩展。我们认为这是一个模块化的协议,它可以作为“分拆”的基础与自定义构建块方法,如:(i)样品制备改性支持从深加工的食品中提取蛋白质,(2)数据采集用于不同的乐器,或(3)数据解释包括性识别。我们已经接触了SPIN的更高级的用例,比如杂交物种的识别,比如骡子。此外,它可以适应,从多个分类群溶解蛋白质混合物或量化蛋白质损伤,在未来。最后,由于每个样品的分析成本的降低和高度的自动化程度,我们预计SPIN工作流程将使LCMS/MS对每个人更容易访问。
参考文献:
Rüther, P. L., Husic, I. M., Bangsgaard, P., Gregersen, K. M., Pantmann, P., Carvalho, M., ... & Olsen, J. V. (2021). SPIN-Species by Proteome INvestigation. BioRxiv.