
滑铁卢大学计算机学院成功利用软件个性化治疗癌症
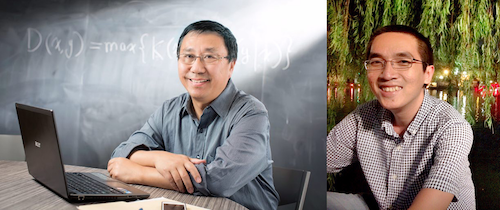
近日,滑铁卢大学计算机科学学院的研究人员成功应用机器学习来识别肿瘤特异性抗原,这将帮助个性化癌症疫苗更准确实施。在一次专访中,研究人员为大家详细介绍了这一方法原理及应用前景。
在癌症中,细胞中的DNA发生错义突变,DNA中的单个核苷酸的替换会导致细胞中产生的不同氨基酸。Hieu Tran博士说:” 尽管这种具有突变氨基酸的肽段是由我们自身的癌细胞合成,但也会被我们的免疫系统识别为外来物。”
这种突变的多肽被称为新抗原( neoantigen),这种抗原只存在于癌细胞的表面,Hieu Tran说:“如果我们能弄清楚癌细胞上的新抗原是什么,那么我们就可以开发一种能够使用患者自己的免疫系统来攻击肿瘤的个性化癌症疫苗。”
“当一个细胞发生癌变时,人类白细胞抗原(HLA)系统会察觉。” 李明教授补充说。“HLA系统将多肽呈递到细胞表面。如果HLA系统在细胞表面呈递的是正常的多肽,我们免疫系统中的T细胞就知道这是一种自体肽并不会攻击它。T细胞只攻击具有突变多肽的细胞,也就是那些表面有新抗原的细胞。”
然而,如果用传统的方法去做,寻找这些肿瘤特异性的新抗原像是大海捞针,是非常困难的任务。但寻找新抗原对开发个性化的癌症疫苗却至关重要。
氨基酸是多肽的组成部分并最终构成蛋白质分子。通常,氨基酸是用一个字母来标记。例如,丙氨酸标记为A,精氨酸标记为R,天冬酰胺标记为N等等。一个肽段的氨基酸序列可以被看作是一个由这些字母组成的单词。
如果你熟悉自然语言处理,你很可能在写短信时看到过你的手机在猜你可能键入的下一个单词。你写‘how’,会提示‘are’,如果你输入‘are’,系统会提示‘You’。” Hieu Tran说。
“我们应用了一个相似的机器学习模型,以这个单字母氨基酸代码为基础来确定新抗原的氨基酸序列。如果我知道你的免疫多肽组——成千上万的8到12个氨基酸长度的短肽抗原被展示在细胞表面,并且一个新抗原与已存在的多肽只有一个突变位点的差异,我可以训练一个机器学习模型,通过你的正常多肽去预测突变多肽。通过使用一种递归神经网络——我们称之为DeepNovo的机器学习模型——来预测新抗原的氨基酸序列。”
研究人员下载了五名黑色素瘤(一种皮肤癌)患者的免疫多肽组数据集,然后他们用这些数据来训练、验证和测试他们的机器学习模型。
Hieu Tran说:“我们的机器学习模型将这些患者预测的免疫多肽组提高了5%到15%。我们还发现了新抗原,包括那些在以前的研究中没有报道过的T细胞应答。”
更令人印象深刻的是,机器学习模型能够实现个性化结果输出——也就是说,它为每个患者识别个性化特定的新抗原。
李教授补充说:“肿瘤免疫疗法正在迅速成为除手术、化疗和放疗外,第四种肿瘤治疗方法。每个病人都不一样,每种癌症也不一样,所以肿瘤治疗不应该对所有人都是一样的。治疗应该为患者量身定制,而这正是我们的个性化机器学习模型能帮助实现的。”
Reference:
Tran, N.H., Qiao, R., Xin, L. et al. Personalized deep learning of individual immunopeptidomes to identify neoantigens for cancer vaccines. Nat Mach Intell 2, 764–771 (2020). https://doi.org/10.1038/s42256-020-00260-4

- 瑞顶赴内蒙古大学完成树木年轮分析系统交付及培训
- 2026金砖国家技能发展与技术创新大赛决赛的报到通知
- 滨松LCOS-SLM与sCMOS相机助力光遗传学解锁大脑奥秘
- 突破21000篇!爱必信absin产品文献引用再创里程碑
- 四次助力!诺贝尔物理学奖背后再现滨松光电倍增管
- 曼博生物携手BlueWhale BioT细胞激活剂落地中国大陆
- 喜报:星朗浩宇正式成为德国Innolume公司一级代理
- 北大联合清砥量子在单细胞黏附动力学领域取得进展
- 伯豪发布Atera送样实操指南,并开放首批预订通道
- 洁特生物连续三年摘得EcoVadis银牌奖章
- QD中国推出超分辨成像与生物电镜双平台联动应用方案
- 洛科自研SolarVac旋转多连过滤座荣获发明竞赛银牌奖
- 食品安全新国标正式发布:普瑞邦助力真菌毒素检测
- 千垛流体与柏诚股份达成战略合作,共建无锡制造基地
- 共建太空医学:基尔比3D细胞类器官系统成关键支撑
- 2026 CNHUPO 大会圆满落幕,未来继续与PEAKS同行
- 讲座:构建单细胞图谱解析Nectin-4助力ADC药物研发
- PEAKS与您相约 2026 CNHUPO&π-HuB全球峰会
- 在线讲座:CSD-CrossMiner药效团挖掘与骨架跃迁
- BSI蛋白质组学质谱数据分析实战应用培训班-上海站
- 康昱盛邀您参加2026 Lhasa中国用户会
- 康昱盛邀您参加MOE 2026亚太用户会
- 讲座预告:PEAKS系列软件赋能组学研究与生物药研发
- PEAKS邀您参加大队列蛋白质组数据自动化研究讲座
- 讲座:Compliance Checker管控化合物合规筛查方案
- 讲座:PEAKS® 13.5 驱动的 DIA 数据深度挖掘分析
- 日程更新:全新蛋白质组学解决方案在线解读讲座
- 康昱盛邀您参加第二届抗体药物发现与设计专题研讨会
- 在线讲座:用Read‑Across定亚硝胺杂质摄入限度
- BSI邀您参加PEAKS 13.5蛋白质组学解决方案解读讲座